Skelette im State Bucket: Identität bleibt für immer
Saisonale Grüße
Seit dem Sommer helfe ich einem großen Kunden beim Refactoring seines Cloud-Application-State, tausche Implementierungen von Resources aus und passe sie an wechselnde Deployment-Kontexte an. Als draußen die Blätter sich zu färben begannen und die Tage kürzer wurden, fühlte es sich an wie ein zäher Horrorfilm: Schatten alter References, zurückgebliebener State, zuvor zerstörte Resources, die wieder aus dem Boden kommen, Skelette und Zombies, die durch die Fleet streifen.
Ich war ratlos. Warum war Infrastructure as Code (IaC) so gut darin, hoch und runter zu skalieren und hunderte Compute-Resources geradlinig zu verwalten, aber so richtig schlecht darin, zwischen Architektur-Designs zu refactoren und zu migrieren?
In diesem Blog geht es um meine Sicht auf diese Gründe, um die Grenzen unseres üblichen Toolings und um ein paar Metaphern, mit denen man über diese Rückstände in Deployments nachdenken kann.
Und falls du länger kein IaC gemacht hast oder keine einfache Möglichkeit hast, einige dieser Dinge zu untersuchen: Dieser Blog ist trotzdem für dich. Ich habe ein kleines Lab beigelegt, das einige der Punkte vorführt und mit dem du experimentieren kannst. Keine Cloud, keine Credentials, keine Services nötig.
Die scharfe Kante von IaC
Die schiere Größe moderner Cloud-Anwendungen macht Ausfall zur Gewissheit, nicht zum Risiko. Wo Fleets von Services für eine optimale Customer Experience zusammenspielen, geht zwangsläufig irgendetwas schief. Festplatten stürzen ab, Mainboards fallen aus, Verbindungen zicken, Software hinkt dem empfohlenen Patch-Level hinterher. Was DevOps als Zustand beabsichtigt hat, ist nicht durchgehend der Fall. Wir sagen: Der State driftet. Und der Zweck von IaC wie Kubernetes oder Terraform/Terragrunt ist, diesen Drift zu korrigieren, die Fleet in den Desired State zurückzuführen. IaC erzeugt die Illusion von Stillstand durch fortlaufende Reconciliation. Denn Stillstand ist das Rückgrat jeder 24/7-Cloud-Anwendung.
Dieser Desired State wird in Code ausbuchstabiert, daher Infrastructure as Code. Typischerweise ist das als Satz von Dateien in einem Source-Code-Repository wie einem gehosteten Git umgesetzt. CI/CD-Pipelines und andere Prozesse sorgen dafür, dass der neueste State in der Fleet abgebildet ist. Resources, die nicht mehr verfügbar sind, werden automatisch durch funktionierende ersetzt. Resources, die nicht mehr gebraucht werden, werden eingezogen. Resources, die fehlen, werden hochgefahren.
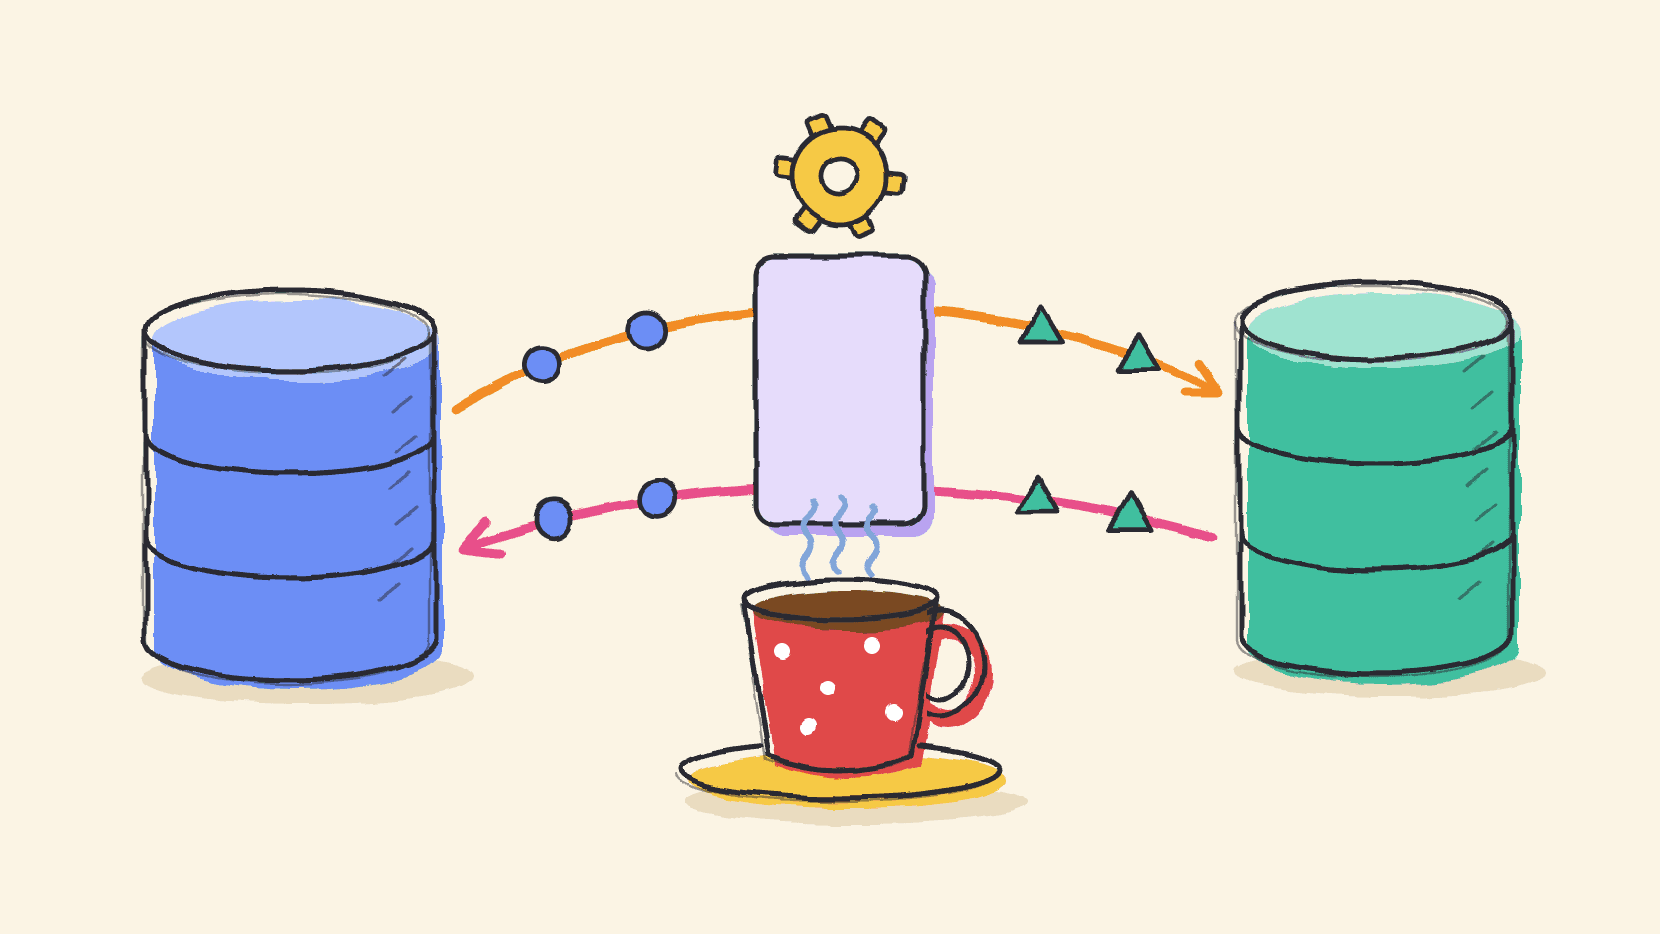
Der State der Cloud-Anwendung besteht aus drei Arten von Information: Addresses im Desired State, die als Keys dienen, interne IDs für die von den Providern bereitgestellten Resources (GCP Storage Buckets, GitLab Project IDs, Kafka Queues), und Application IDs, um programmatisch auf diese Resources zuzugreifen (GS URLs, GitLab Paths, Kafka Topics).
Diese State-Information wird typischerweise von Cloud Storage oder einer eigenen Datenbank gehalten. Das ist der umgangssprachliche "State Bucket" aus dem Titel dieses Blogs.
Konzeptionell überrascht, wie simpel eine Desired-State-Beschreibung ist. Vom gedrifteten in den Desired State zu kommen, ist ein State-Übergang. Das ist eine dreiteilige Relation: tatsächlicher State, Änderung, Desired State. Die Beschreibungskraft von IaC liegt in zwei Vereinfachungen.
- IaC behandelt den tatsächlichen State als nicht erwähnenswert. Der tatsächliche State entspricht entweder der Absicht, dann ist er redundant, oder er ist eine kurzlebige Abweichung, die behoben gehört. Also gibt es keinen Grund, den tatsächlichen State anzugeben.
- Beim Beheben leitet IaC die nötige Änderung aus dem Desired State ab. Also gibt es keinen Grund, die Änderung anzugeben.
Diese zwei Vereinfachungen reduzieren das DevOps-Spezifikationsproblem darauf, den Desired State abstrakt im Source-Repository auszubuchstabieren.
Diese Dreierrelation auf eine einzige Komponente zu reduzieren, funktioniert großartig, bis es das nicht mehr tut. Und die Situation, in der diese Modellierungsverkürzung auf die Nase fällt, ist die, in der der Desired State selbst einen umwälzenden Wandel durchmacht. Nicht im Load-Balancing-Sinn von mehr VMs hier oder einem Datenbankserver weniger dort. Nicht im additiven Sinn eines Caching-Layers oder eines Bastion Hosts. Sondern auf architektonische Weise, wenn ein Ansatz einen anderen ersetzt, etwa Redis, das für Notifications an die Stelle von Kafka tritt. Denn dann müssen wir über zwei Desired States gleichzeitig reden: den bisherigen Desired State, mit Kafka und ohne Redis, und den künftigen Desired State, mit Redis und ohne Kafka. Was genau den Vereinfachungen zuwiderläuft, die IaC macht.
Werkzeuge für den Wandel
Wie unterstützen die Werkzeuge des Fachs so eine Umstrukturierung also? Kurz: Nicht so gut, wie wir es gern hätten.
Terragrunt – zwei States nacheinander modellieren
Da jeder Commit nur einen Desired State darstellen kann, modelliert klassisches Terragrunt so eine Ersetzung über aufeinanderfolgende Commits. Wie spielt sich das in unserem Beispiel ab?
Anfangs existiert nur der "Vorher"-Absichtszustand mit der Kafka-Notification. Auf dem Main-Branch, bei Commit A, enthält der Tree einen Terragrunt-Stack, der die Kafka-Resources beschreibt. Das State-Objekt für den Backend-Key der Resources hält das Notification-Topic, sagen wir events. Dieser Commit A ist der einzige Ort, an dem die alten Dependencies, Inputs und Output-Namen beschrieben sind.
Angenommen, das Team schlägt in einem Architectural Decision Record (ADR) vor, Redis statt Kafka zu verwenden. Es forkt einen Feature-Branch von Commit A und schreibt den Terragrunt-Stack auf Redis-Resources um. Bis zum Merge ist das nur ein Vorschlag. Die History des Branches kann frei rebased werden, da sich an der Welt noch nichts geändert hat.
Der Merge Request MR geht ins Review. Der MR-Diff wird gegen die Merge-Base M gebildet, die nicht die wandernde Spitze von Main sein muss. Der Commit-Range [M...H] zeigt die Entfernung. Beachte: Ein terragrunt plan ohne --filter-allow-destroy zeigt nur eine Warnung und keinen Destroy-Plan (vgl. Experiment e01 in unserem Lab unten), der Reviewer sieht die Entfernung also im Diff, aber nicht die Zerstörung im Plan. Nennen wir das die Review Gap.
Der Merge erzeugt den Commit B des "Nachher"-Absichtszustands mit der Redis-Notification. Main rückt von Commit A auf Commit B vor. In einer Push-Pipeline benennen die CI-Variablen CI_COMMIT_BEFORE_SHA (A) und CI_COMMIT_SHA (B) den Übergang. Der Grund für die Änderung lebt außerhalb beider Trees, in der Merge-Commit-Message oder der MR-Beschreibung, womöglich mit einem Verweis auf das Architectural Decision Record (ADR).
Nach dem Merge auf Main führt die CI/CD-Pipeline den Übergang über etwas wie dies aus:
terragrunt run --all apply \
		--filter '[A...B]' --filter-allow-destroy
Das heißt, Terragrunt materialisiert einen temporären Worktree bei Commit A. Terragrunt findet Units, die bei A vorhanden und bei B abwesend sind, und zerstört sie aus dem Worktree von A heraus, in umgekehrter Dependency-Reihenfolge, und greift dabei auf echte Outputs aus dem Backend-State von A zurück. Dann plant Terragrunt die geänderten und hinzugekommenen Units aus dem Worktree von B und wendet sie an. Ein Lauf bewegt sich in beide zeitliche Richtungen, Vergangenheit und Zukunft, und die beiden Hälften bedingen einander nicht, mit allen Gefahren, die das mit sich bringt.
Zum Schluss wird der State aktualisiert, um das physische Ergebnis abzubilden. Die Resources hinter den Units sind zerstört, und das State-Objekt für die Kafka-Konfiguration bleibt typischerweise ohne Resources darin zurück. Das Fleisch ist weg, und nur das Skelett überlebt im Bucket.
Der einzige Beleg, dass dieser Prozess geklappt hat, ist das grüne Licht in der CI/CD-Pipeline. Die Forge hält dieses Ergebnis, sonst niemand. Das Repository hat die Commits A und B und ihre Verknüpfung, aber die Modifikationen stecken im State. Keines von beiden ist allerdings mit der Absicht verbunden, wie sie das Architectural Decision Record festhält, das diese State-Änderung überhaupt erst ausgelöst hat. Damit ist der volle State-Übergang nicht sauber modelliert.
Trotzdem zeigt der Durchgang klar, warum dieser volle Übergang nötig ist, warum beide Enden des Übergangs modelliert sein müssen, nicht nur der finale Desired State, der Default von IaC. Terragrunt kann die alten Resources ohne den Tree von A nicht zerstören, weil der Destroy sowohl den Dependency-Graph als auch die Outputs braucht. Die Mechanik verlangt sie, und die Commit-Abfolge ist der einzige Ort, an dem beide überleben.
Und beachte die Fragilität. Der Übergang wird durch ein Paar von Commit-Hashes auf einer First-Parent-Linie von Main identifiziert. Jedes Rebase, jeder Force-Push, jedes Squash, das A oder B verschiebt, verändert potenziell den Übergang, der ausgeführt wird. Die Formbarkeit des Repositorys hilft hier nicht, einen genauen Record zu bewahren. Und da der Absichts-Record nicht Teil des Merges ist, der das Commit-Paar etabliert hat, bindet nichts den ausgeführten Übergang an seine Begründung, außer vielleicht Konvention.
Terraform 1.7 – entfernte Resources modellieren
Terraform 1.7 führte den removed-Block ein, vermutlich, um die Beschreibung der Entfernung aus der Commit-Abfolge herauszuziehen und direkt in die Terraform-Beschreibung zu legen. Spoiler: Das löst die Branch-Fragilität und die Review Gap, aber es schließt die Knowledge Gap nicht. Gehen wir das Beispiel noch einmal mit aktualisiertem Tooling durch, um zu verstehen, warum das so ist.
Wieder existiert am Anfang nur der "Vorher"-Absichtszustand mit der Kafka-Notification. Auf dem Main-Branch, bei Commit A, enthält der Tree einen Terragrunt-Stack, der die Kafka-Resources beschreibt. Angenommen, es ist der beliebte mongey-Kafka-Provider, dann existiert eine Resource unter der Address kafka_topic.events im State-Objekt des Backends.
Als Nächstes hält das Team die Absicht in einem ADR fest und verfasst einen Merge Request. Ein Branch, der von A forkt, enthält den aktualisierten Terragrunt-Stack. Der MR enthält zwar die Redis-Resource-Definitionen, aber darum geht es hier nicht. Wichtiger ist: Der MR entfernt den Resource-Block des Kafka-Event-Topics und ersetzt ihn durch einen removal-Block.
removed {
	from = kafka_topic.events
	lifecycle {
		destroy = true # false would only forget it
	}
}
Weil der MR die Änderung in einem einzigen Commit beschreibt, kann der terraform plan die Zerstörung sauber zeigen. Das ist eine riesige Verbesserung, weil es die Review Gap zum Zeitpunkt der Plan-Freigabe schließt.
Der Merge erzeugt dann den neuen Commit B. Der eine Commit fügt den removed-Block hinzu, löscht aber den Resource-Beschreibungsblock für kafka_topic.events. Die beiden Blöcke bleiben über den from-Key verknüpft, der einen Abgleich gegen den State erzwingt.
Die CI/CD-Pipeline kann nun auf den Merge reagieren. Da alle Informationen vorhanden und für die Planung sichtbar sind, braucht sie nur den Worktree von B. Terraform gleicht die State-Address gegen den removed-Block ab, zerstört die Resource und wirft die Address aus dem State-Objekt im Backend. Da kein temporärer Worktree bei A nötig ist, braucht es keine Sequenz [A...B], nur den Commit B. Einen einzelnen Commit zu rebasen ändert den beabsichtigten Übergang nicht.
Wenig überraschend hält der State das Ergebnis fest und entfernt die Address aus dem State.
Was ist mit dem removed-Block? Hier beginnt das Drama. Ein Block im Code ist jetzt zum Grabstein geworden. Das Wissen um diese Löschung steckt nicht im State, sondern in der Beschreibung. Diese Beschreibung ist nicht nur Default-Destroy, sie lebt auch in der überschreibbaren History eines Repositorys. Cleanup, der im Resource-Block lebt, ist an diesen gebunden: Ein nackter Grabstein reißt den Provisioner mit sich und lässt das Fleisch zurück (e07 s1).
Und dieser Grabstein muss bestehen bleiben, bis jeder State, der diese Address hält, ihn angewandt hat. Entfernt ihn jemand, nachdem das Main-Environment das Apply ausgeführt hat, aber bevor ein hinterherhinkendes es tut, sieht das nachzüglerische Environment eine Address ohne Config und ohne Grabstein, also plant Terraform einen Destroy, den Default, gegen den erklärten Zweck des Grabsteins (e07 s3).
Sind aber erst einmal alle Environments gelaufen und ist der Grabstein aufgeräumt, kann jeder alte Branch die Resource fröhlich wiederherstellen. Der State erinnert sich nur daran, was existiert, nicht an das, was zerstört wurde.
Im Lab plant ein überlebendes Environment, das den Destroy nie angewandt hat, einen zweiten Create neben der Resource, die es noch betreibt (e07 s4), auch wenn die meisten echten Provider das Duplikat wahrscheinlich mit "already exists" markieren würden. Trotzdem unterstreicht das, dass der einzige Record der Stilllegung im Tree steckt, so fokussiert auch in einem einzigen Commit, aber eben kritischerweise nicht im State.
Diskussion
Wer dahingeht, lässt etwas zurück. Doch unser Tooling gibt diesen Überbleibseln kein Zuhause.
Wie unsere Zeichnung gezeigt hat, hält der State von Terraform drei Arten von Information: Addresses, die die Config als Keys nutzt, interne IDs, die der Provider nutzt, und Application IDs, die andere Systeme nutzen, um die Resource zu erreichen. Nur die ersten beiden sind für das Tooling sichtbar. Application IDs sind die Namen, an die sich andere Dinge binden, etwa der Kafka-Topic-String, auf den Producer schreiben. Sie werden vom selben Code vergeben, der das Fleisch deklariert, aber nichts hält fest, dass sie Identitäten sind und nicht Implementierung. Wird das Fleisch entfernt, sagt ein removed-Block nichts über sie. Manche sind eigene Resources und überleben, zeigen auf einen Endpoint, den es nicht mehr gibt. Andere sind Module-Inputs und verschwinden mit dem Modul, der erste Consumer, der sie auflösen will, scheitert ohne Terraform-Fehler. Das Schicksal dieser Identitäten hängt davon ab, wie der Code zufällig strukturiert war.
Der natürliche Ort, diesen Record zu pflegen, ist das Architectural Decision Record. Ein ADR sagt, warum Kafka Redis wich, welche Identitäten stillgelegt und welche übernommen werden. Es ist das einzige Artefakt, das die Begründung für den Absichtswechsel hält. Aber ADRs sitzen außerhalb der Toolchain. Das IaC kann sie nicht als Zeugen heranziehen, um den State zu bewachen.
Der naheliegende Flicken ist, den Tree mehr vom Record tragen zu lassen. Ein removed-Block pro stillgelegter Address, behalten, bis jedes Environment ihn angewandt hat, erfasst die Stilllegung tatsächlich im Commit, der sie einführt. Aber er streut den Record über den Code, ein Grabstein pro Resource, jeder mit eigener Lebensdauer. Das Ergebnis ist ein Wald aus Blöcken und verschleiert, wie sich das System als Ganzes entwickelt hat. Teams werden die Zombie-Tür wieder aufmachen, nur um ihre Sicht zu entrümpeln, ein gruseliger Tradeoff.
Identität hat also kein erstklassiges Zuhause. Der State kennt die Maschinen-IDs und Addresses, aber nicht die Namen, von denen der Code abhängt. Der Tree kennt die Namen, aber nur als überschreibbaren Snapshot. Das ADR kennt den Grund, aber das Tooling kann es nicht abfragen.
Kein Wunder, dass heimatlose Identitäten in der Halloween-Nacht umherstreifen.
Bonusrunde 1: Die Metaphern-Karte
Wenn man diese Themen im Team bespricht, ist es praktisch, eindrückliche Metaphern für diese komplexen Prozesse und Situationen zu haben.
| Halloween | Infrastruktur | Anmerkungen |
|---|---|---|
| Skelett | Identität: die Namen und IDs, an die sich andere Systeme binden, der State-Key, Grants und Rollen | Überlebt das Fleisch. Benutze die Knochen nie wieder. |
| Fleisch | Die Resource selbst: der Kafka-Cluster, seine Broker und Volumes | Was der destroy entfernt. |
| Grabstein im Vorgarten | State-basierte Löschung: ein removed-Block | Sichtbar, und bleibt, bis ihn jemand wegräumt. |
| Phantom | Verwaister State: event-basierte Löschung, deren Moment vorbei ist (e04 s1) | Nichts in der Config zeigt darauf, aber seine Resources leben weiter. |
| Geist | Verwaiste Config ohne Backing | Die Config zeigt darauf, aber die Resource ist schon weg, Begriff aus Firefly |
| Zombie | Auferstehung: eine zerstörte Unit, von einem veralteten Branch zurückgeholt (e04 s3b), oder ein neues Produkt, das alte Identitäten kopiert | "Zombie Resources" ist bereits ein Branchenbegriff. Wir geben ihm zwei Hintergrundgeschichten. |
| Poltergeist | Verlorener Destroy-Time-Seiteneffekt: ein Provisioner oder Cleanup-Schritt, der nur lief, solange seine Config existierte (e07 s3) | Das Objekt ist weg, aber was es tat, passiert noch. Nichts im State oder im Repo hält es fest. |
| Halloween (eine Nacht, in der der Schleier dünn ist) | Der bewusste Stilllegungslauf | --filter-allow-destroy ist das Tor, absichtlich geöffnet und dann wieder geschlossen. |
| Spukhaus | (1) Ein Lauf, in dem die Toten und die Lebenden in entgegengesetzte Richtungen ziehen und stecken bleiben (e03). (2) Ein Repo, dessen Dependency-Graph an drei Orten lebt | |
| Phantomjagd | Ein Durchlauf nach State, den keine Config und kein Grabstein erklärt (e06), findet keine Poltergeister, da die keine Config haben | Ein level-getriggertes Sicherheitsnetz. |
Spielen wir es für unser Leitbeispiel durch. Die Kafka-zu-Redis-Geschichte bildet sich direkt auf die Palette ab. Der Kafka-Cluster als Cloud-Resource ist Fleisch. Der Topic-Name events und seine Consumer-Group-Offsets sind Skelett. Der removed-Block ist der Grabstein. Ein Lauf, der Kafka zerstört und zugleich Redis erzeugt, ist ein Spukhaus. Passiert der Destroy nie und erwähnt ihn der Range keines späteren Laufs, ist der Kafka-State ein Phantom. Wird der Kafka-Cluster außerhalb der CI/CD-Pipeline entfernt, ist die Konfiguration im State ein Geist. Ein alter Branch, der das events-Topic noch deklariert und anwendet, ist der Zombie.
Bonusrunde 2: Das Lab
Das begleitende Lab zu diesem Blog liegt auf Posedios GitHub, die Details stehen in der README.md.
Das Lab gibt es, damit sich jede Verhaltensbehauptung in diesem Post überprüfen lässt. Es hat zwei Stufen. Die Core-Experimente (e01 bis e07) brauchen nur Shell-Tools. Sie laufen mit make in 1 bis 2 Minuten, ohne Cloud, ohne Credentials, ohne Services. Da e03 einen festgefahrenen State über einen Timeout demonstriert, braucht es allein rund 40 Sekunden.
Das Backend-Experiment (b01) braucht einen lokalen S3-kompatiblen Server, den der Leser startet. Es läuft nur mit einem expliziten make backend, es weist alles außer localhost ab, und es erzwingt Dummy-Credentials, sodass der Lab-State keinen echten Account erreichen kann.
Jedes Experiment hält zwei Arten von Ergebnissen fest. Ein Claim ist dokumentiertes Verhalten, das dich trotzdem überraschen kann. Eine Observation ist undokumentiertes Verhalten, das das Lab aufgezeichnet hat. Die Ergebnisse wurden mit Terragrunt v1.1.3 und Terraform v1.14.8 auf macOS arm64 beobachtet. Das Lab ist der Beleg für das Argument. Es ersetzt das Argument nicht.
Referenzen
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •
- •