Dein Agent. Deine Geschäftsanforderungen.
Wann hast du zuletzt etwas aus der Arbeit in einen privaten KI-Chat kopiert, nur um schnell eine Antwort zu bekommen? Die Antwort wirkt brauchbar, sie kommt sofort, und niemand muss davon erfahren. Allerdings liegen die Unterlagen deines Unternehmens jetzt auf einem fremden Server, und woher die Antwort tatsächlich stammt, kann niemand mehr nachvollziehen.
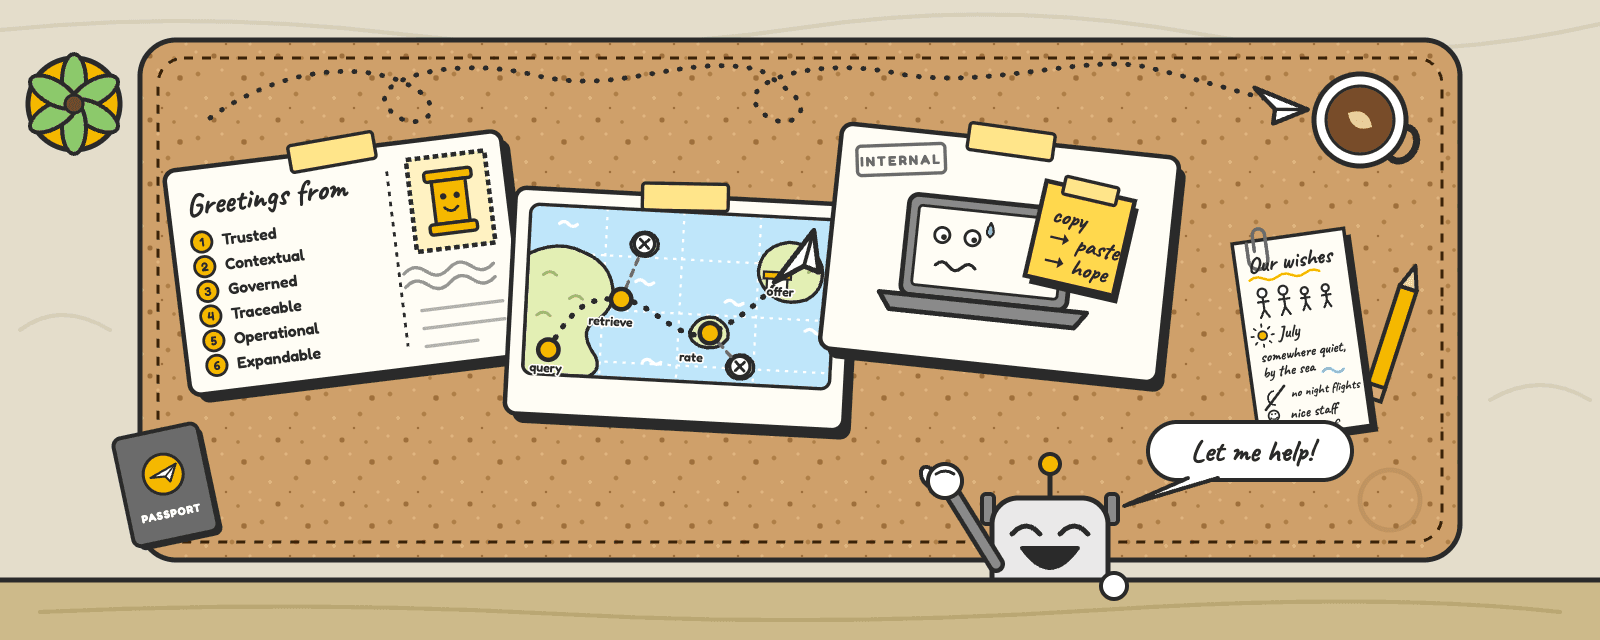
Als wir unseren ersten eigenen Agenten entwickelt haben, haben wir einige Praktiken erarbeitet und dabei sechs Säulen gefunden, die darüber entscheiden, ob ein Agent für eine konkrete Geschäftsanforderung im Arbeitsalltag tatsächlich nützt: Er muss vertrauenswürdig (trusted), kontextbezogen (contextual), kontrolliert (governed), nachvollziehbar (traceable), produktiv einsetzbar (operational) und erweiterbar (expandable) sein. Diese Säulen helfen dabei, den Agenten zu entwerfen und die eigenen Daten auf ihn vorzubereiten. Abgeleitet haben wir sie von den Ebenen, die Pramod Sadalage und Prem Chandrasekaran beschreiben, um Daten für agentische KI bereit zu machen [1].
Wie lässt sich das am besten erklären? Mit Alex, die seit Kurzem als Beraterin in einem Reisebüro arbeitet, und ihrer allerersten Kundenanfrage.
Alex, das Reisebüro und alle Zahlen in diesem Beitrag sind selbstverständlich frei erfunden und stehen für keine realen Personen oder Unternehmen. Aber lass dich trotzdem kurz auf dieses kleine Gedankenspiel mit uns ein.
Montagmorgen
Alex hat vor einer Woche in einem Hamburger Reisebüro angefangen. An ihrem ersten Tag mit Kundschaft setzt sich eine vierköpfige Familie an ihren Schreibtisch und beschreibt zwei Stunden lang ihren Urlaub: „Wir sind zu viert, im Juli, irgendwo ruhig am Meer. Keine Nachtflüge … Ach, und das Hotelpersonal sollte nett sein.“ Sobald die Familie gegangen ist, liegt die Arbeit bei Alex. Bis Freitag braucht sie Flüge für vier Personen im Juli und ein ruhiges Hotel in Strandnähe, wobei Verfügbarkeit, Preise, Stornobedingungen und die Regeln der Anbieter geprüft sein müssen, außerdem einen Reiseplan, der unter 3.000 € bleibt, sowie ein Angebot und eine Rechnung, die der Familie vorliegen.
Ihr erster Impuls ist, ein LLM zu fragen. Da das Reisebüro keine interne oder unternehmensweite Lösung für die Nutzung von LLMs hat, öffnet sie das private Abo, für das sie ohnehin bezahlt. Weil sie neu ist und die Antwort zur Arbeitsweise des Reisebüros passen soll, kopiert sie zusätzlich einige interne Dokumentationen in den Chat. Die Antwort wirkt nützlich, doch der Weg dorthin ist ein Problem: Interne Unternehmensdokumente liegen nun in einem privaten Konto außerhalb der Kontrolle des Reisebüros, und nichts an der Antwort lässt sich auf eine Quelle zurückführen. Mit dieser Situation steht Alex keineswegs nur in der Reisebranche da. Im Work Trend Index 2024 von Microsoft und LinkedIn gaben 78 % derjenigen, die KI nutzen, an, eigene KI-Tools mit zur Arbeit zu bringen, was Unternehmensdaten nach Einschätzung von Microsoft einem Risiko aussetzt [2].
Hinzu kommt, dass der Chat von den Systemen des Reisebüros abgekoppelt bleibt. Er sieht weder die Verfügbarkeiten im Buchungssystem noch die Regeln der Anbieter, er kann weder Angebot noch Rechnung erstellen, und die Unternehmensrichtlinien kennt er nur so weit, wie die eingefügten Dokumente sie zufällig abdecken. Die Familie beschreibt ihren Urlaub zudem mit Begriffen, für die das interne Buchungstool des Reisebüros keinen Filter anbietet, etwa „ruhig“ oder „nettes Personal“. Was das Reisebüro tatsächlich braucht, ist ein Agent, der im Unternehmen läuft, Zugriff auf dessen Daten, Richtlinien und Systeme hat und nach Regeln arbeitet, die das Unternehmen selbst festlegt.
Was der Agent leisten muss, um diese Anfrage zu übernehmen
Was wäre nötig, um diese Anfrage einem Agenten zu übergeben? Seine Struktur muss der Arbeit entsprechen, die Alex erledigt, und der Prozess, den das Reisebüro im Onboarding vermittelt, lässt sich in vier Muster zerlegen. Angebot, Buchung und Rechnung folgen immer derselben Reihenfolge, weshalb dieser Teil eines Agenten als lineare Abfolge umgesetzt werden kann, in der das Modell nicht über die Reihenfolge der Schritte entscheidet. Bandara et al. empfehlen, Schritte, die kein sprachliches Schlussfolgern erfordern, als einfache Funktionsaufrufe in der Orchestrierungsschicht abzubilden, statt sie dem Modell zu überlassen [3].
Die Suche nach einem Angebot unter 3.000 € ist dagegen eine Schleife: Alex sucht, prüft, ob das Ergebnis zum Budget und zu den Wünschen der Familie passt, und sucht mit angepassten Parametern erneut, bis es passt, was in einem Agenten eine klare Abbruchbedingung voraussetzt. Die Wahl eines Anbieters samt der dazugehörigen Richtlinie ist wiederum eine Verzweigung, die sich als Graph aus Entscheidungstabellen modellieren lässt, sodass ein Agent für jeden Anbieter die Regeln des Reisebüros befolgt, anstatt sie zu erfinden. Die Suche nach Flügen und die Suche nach Hotels hängen schließlich nicht voneinander ab und können parallel laufen, wobei ein Koordinator die Ergebnisse einsammelt.
%%{init: {"theme": "base", "themeVariables": {"background": "#ffffff", "clusterBkg": "#f2f2f2", "clusterBorder": "#d0d0d0", "primaryColor": "#ffffff", "primaryBorderColor": "#9a9a9a", "primaryTextColor": "#222222", "secondaryColor": "#f2f2f2", "tertiaryColor": "#f2f2f2", "lineColor": "#666666", "edgeLabelBackground": "#ffffff"}}}%%
flowchart TB
    subgraph lin["Linear: feste Reihenfolge"]
        direction LR
        q("Angebot") --> bo("Buchung") --> inv("Rechnung")
    end
    subgraph lp["Schleife: wiederholen, bis es passt"]
        direction LR
        se("Suche") --> fi{"Passt?"}
        fi -- "nein" --> se
        fi -- "ja" --> of("Angebot")
    end
    subgraph gr["Graph: verzweigte Entscheidungen"]
        direction LR
        ws{"Welcher Anbieter?"} --> pa("Richtlinie A")
        ws --> pb("Richtlinie B")
    end
    subgraph par["Parallel: nebeneinander"]
        direction LR
        co("Koordinator") --> fl("Flüge")
        co --> ho("Hotels")
    end
lin ~~~ lp ~~~ gr ~~~ parDas Diagramm konnte nicht dargestellt werden – hier ist der Quelltext.
Überträgt man den Prozess auf diese Bausteine, wird sichtbar, an welchen Stellen ein Agent Daten und an welchen er Regeln braucht. Die Suchschritte benötigen Preise, Verfügbarkeiten und Wissen über die Hotels, die Verzweigungen benötigen die Regeln der Anbieter und die Unternehmensrichtlinien, und für den Paketschritt braucht der Agent Zugriff auf das Buchungssystem, um Angebot und Rechnung zu erstellen. Was also braucht der Agent, um diese Arbeit zu leisten?
1. Vertrauenswürdig (Trusted): Schlechte Daten rein, selbstbewusst falsche Antworten raus
Alex fragt nach dem Preis des Aurora Bay im Juli. Das Aurora Bay ist ein Strandhotel, mit dem das Reisebüro zusammenarbeitet und das gut zur Familie zu passen scheint. Ein altes Preisblatt führt es im Juli mit 214 € pro Nacht, allerdings stammt dieser Preis aus dem vergangenen Winter. Ein Agent, der dieses Blatt erhält, übernimmt die 214 € ohne jeden Hinweis auf ihr Alter in sein Angebot, weil er aktuelle und veraltete Daten nicht voneinander unterscheiden kann.
Bevor ein Agent überhaupt etwas planen kann, braucht er Daten, die zwei Bedingungen erfüllen: Sie müssen von hoher Qualität sein, und der Agent muss ihre Struktur und Bedeutung verstehen, idealerweise ohne direkten Zugriff auf die dahinterliegenden Quellsysteme. Zwischen der Datenreife, die Unternehmen sich selbst bescheinigen, und der tatsächlichen scheint dabei eine große Lücke zu klaffen. Im Report „2026 State of Data Integrity and AI Readiness“ von Precisely und dem LeBow College of Business der Drexel University halten sich 87 % der mehr als 500 befragten Führungskräfte aus Data und Analytics für bereit für KI, während 43 % die Datenreife als ihr größtes Hindernis nennen [4]; Sadalage und Chandrasekaran verweisen auf denselben Befund [1].
Angenommen, das Reisebüro arbeitet mit 600 Hotels zusammen, von denen jedes einen eigenen Preis-Feed mit eigenen Regeln und eigener Struktur liefert. Wie lassen sich die Erwartungen, die das Reisebüro an diese Daten stellt, verbindlich festhalten? Eine Möglichkeit ist ein Data Contract nach dem Open Data Contract Standard [5], der einen Datensatz über Schema, Semantik, Qualitätsregeln und ein SLA beschreibt. Der Contract kommt dabei an zwei Stellen zum Einsatz. Die Datenpipeline läuft unabhängig vom Agenten und prüft eingehende Preise anhand der Qualitätsregeln und des SLA, wobei sie alles herausfiltert, was die Prüfung nicht besteht, sodass nur valide Daten in den Datensatz gelangen, mit dem der Agent arbeitet. Der Agent selbst fragt diesen Datensatz ab und versteht anhand der Feldbeschreibungen im Contract, was jeder Wert bedeutet, ohne die Quellsysteme untersuchen zu müssen. Für den Preis-Feed der Hotels sieht der Contract so aus:
schema:
  - name: hotel_rates
    properties:
      - name: hotel_id
        logicalType: string
        description: supplier hotel id
      - name: nightly_rate
        logicalType: number
        description: Rate for one night, one room, excluding taxes and fees
        quality:
          - rule: validValues
            mustBeBetween: [10, 5000]
      - name: hotel_name
        logicalType: string
        physicalType: varchar(200)
        required: true
        description: Display name of property.
    quality:
      - type: sql
        description: one rate per hotel, room type, stay date
        mustBe: 0
slaProperties:
  - property: freshness
    value: 24
    unit: h
Mit einem Freshness-SLA von 24 Stunden fällt der Winterpreis des Aurora Bay durch die Prüfung, und dasselbe gilt für jeden Datensatz, der gegen eine der Qualitätsregeln verstößt. Die Beschreibung von nightly_rate teilt dem Agenten zudem mit, dass Steuern und Gebühren in dem Preis, den er der Familie nennt, nicht enthalten sind, ohne dass er die Preistabelle jemals selbst öffnen muss.
Ein Contract beschreibt allerdings nur, wie gute Daten aussehen, und verhindert nicht, dass schlechte Daten ankommen. Preis-Feeds stammen aus APIs der Anbieter, aus Datenbanken und aus Streams, und liest der Agent direkt aus diesen Quellen, kann jeder veraltete Preis im Angebot für die Familie landen. Wie stellt das Reisebüro also sicher, dass nur geprüfte Daten beim Agenten ankommen? Dafür braucht es eine Datenpipeline mit einem einzigen Ziel: Ein Agent bekommt ausschließlich qualitativ hochwertige Daten zu sehen, die alle Prüfungen bestanden haben.
Eine Möglichkeit dafür ist die Medallion-Architektur, ein Entwurfsmuster für Daten, das in der Dokumentation von Databricks beschrieben ist [6] und das Sadalage und Chandrasekaran auf agentische Systeme übertragen [1]. Daten aus den Quellsystemen landen zunächst als unveränderliche Rohdaten in der Bronze-Stufe, die den Audit-Trail und die Herkunft der Daten (Lineage) bewahrt. Anschließend prüft eine Contract-Verifikation Schema, Aktualität und Qualität: Daten, die bestehen, wandern validiert und dedupliziert in die Silber-Stufe, während Daten, die durchfallen, in einer Dead Letter Queue landen statt beim Agenten. Ein zweiter Schritt wendet Zertifizierung, Geschäftsregeln und Abgleich an, bevor die Daten die Gold-Stufe erreichen, aus der ein Agent ausschließlich liest.
Die Prüfungen stammen aus dem Data Contract. Dokumente durchlaufen dieselben Stufen, wobei die Prüfungen aus ihrem Frontmatter kommen (siehe Säule 2). Für strukturierte Daten ist das einfach genug umzusetzen, doch wie sieht es mit unstrukturierten Daten aus?
2. Kontextbezogen (Contextual): Welches Hotel hat freundliches Personal?
Alex sucht ein Hotel mit freundlichem Personal, doch dafür hat das Buchungstool kein Feld, und dasselbe gilt für die beiden anderen Wünsche der Familie, nämlich Ruhe und einen kurzen Weg zum Strand. Ob das Aurora Bay laut ist, steht nur in Google-Bewertungen und Fragebögen. Die Entfernung zum Strand ist relativ, denn zehn Minuten zu Fuß sind etwas anderes als zehn Minuten mit dem Bus. Wie das Personal ist, verteilt sich wiederum auf E-Mails von Gästen, Feedbackformulare und eingescannte PDFs, die sich über die Jahre angesammelt haben und in jeder denkbaren Form geschrieben sind.
Für diese Art von Daten ist idealerweise eine Wissensbasis das Ziel, die Menschen und Agenten gleichermaßen verstehen und pflegen können, anstatt dass ein Agent eigenständig Postfächer und Dateifreigaben durchsucht. Doch wie baut man eine solche Wissensbasis für Daten, die kein Schema haben und täglich wachsen? Eine Möglichkeit für solches Material ist Retrieval-Augmented Generation (RAG) über das Archiv [7]. In aktuellen Projekten bei Posedio haben wir allerdings festgestellt, dass der größte Aufwand darin liegt, mit den Änderungen Schritt zu halten: Bewertungen kommen täglich herein, und jede neue Lieferung bedeutet Vorverarbeitung, Chunking und erneutes Embedding, bevor der Agent sie nutzen kann.
Als vielversprechende Alternative sehen wir bei Posedio das Open Knowledge Format (OKF), das Google Cloud im Juni 2026 veröffentlicht hat [8]. OKF speichert Wissen als Verzeichnis von Markdown-Dateien mit YAML-Frontmatter, die Menschen wie jedes andere Dokument lesen und bearbeiten können, während ein Agent durch sie navigieren und sie lesen kann. Damit entspricht das Format genau dem Ziel einer Wissensbasis, die beide Seiten verstehen und pflegen können.
Mit OKF sieht die Wissensbasis des Reisebüros so aus:
knowledge/
├── index.md
└── hotels/
    ├── index.md
    ├── aurora-bay/
    │   ├── index.md
    │   ├── neighborhood.md
    │   ├── staff-service.md
    │   ├── beach-access.md
    │   └── contract-2025.pdf
    └── marina-plaza/
        ├── index.md
        └── neighborhood.md
Jeder Ordner enthält eine index.md, die dem Agenten sagt, was er darunter findet:
# Aurora Bay

## Guest experiences

- [Neighborhood](neighborhood.md) - noise, nightlife, transport
- [Beach access](beach-access.md) - distance and route to the beach
- [Staff service](staff-service.md) - front desk and housekeeping

## Commercial

- [Contract 2025](contract-2025.pdf) - rates, source of record
Jedes Dokument hat ein eigenes Frontmatter, das angibt, was es enthält, woher es stammt und wer es lesen darf:
---
type: PropertyNote
title: Aurora Bay - Noise
description: Street noise by room orientation
resource: knowledge/hotels/aurora-bay/neighborhood.md
tags: [noise, transport]
lifecycle: current
review_date: 2026-09-09
source: guest_reviews
visibility: agent_readable
---
OKF schreibt lediglich das Feld type vor und definiert eine kleine Zahl weiterer Felder wie title, description, resource, tags und timestamp [8]. Ein Vorteil des Formats besteht darin, dass sich das Frontmatter um eigene Felder erweitern lässt, in diesem Beispiel um lifecycle, review_date, source und visibility, sodass Informationen zu Qualität und Governance direkt neben dem Inhalt liegen, wo Pipeline und Agent sie gleichermaßen nutzen können. Das Beratungsteam pflegt die Dokumente, während der Agent denselben Arbeitsbereich nur lesend nutzt. Eigene Tools wählen die relevanten Dokumente aus, sodass kein Zyklus aus erneutem Embedding entsteht, und das Frontmatter grenzt jede Suche ein, bevor auch nur ein einziges Dokument geöffnet wird.
Das vorhandene Material in diese Struktur zu überführen, ist ein einmaliger Aufwand, den eine KI-Pipeline unterstützen kann; danach bedeutet Aktualität lediglich, jeweils ein Dokument hinzuzufügen oder zu aktualisieren. Die Stufen der Pipeline finden sich im Frontmatter als Lifecycle-Zustände draft, reviewed, current und deprecated wieder, wobei nur Dokumente im Zustand current für den Agenten sichtbar sind. Eine ungeprüfte Bewertung oder eine veraltete Notiz zum Personal bleibt so ebenso außer Reichweite des Agenten wie ein veralteter Preis.
3. Kontrolliert (Governed): Minimale Rechte, keine Abkürzungen
Angenommen, Alex bittet den Agenten, den Preis des Aurora Bay direkt aus contract-2025.pdf zu übernehmen, also aus der maßgeblichen Quelle, und stellt fest, dass der Agent die Datei nicht öffnen kann: Der Vertrag ist nicht als für den Agenten lesbar gekennzeichnet, weshalb der Preis stattdessen aus der geprüften Gold-Tabelle kommt. Wie viel Zugriff sollte ein Agent also bekommen, und was darf er ausführen? Direkter Zugriff auf die Buchungsdatenbank würde den Agenten zwar schneller machen, würde ihm aber zugleich erlauben, mehr zu lesen und zu ändern, als eine Anfrage erfordert. Governance greift deshalb auf zwei Seiten.
Auf der Datenseite legen wir den Zugriff in den Metadaten fest, und zwar über visibility: agent_readable im Frontmatter sowie über den Contract für jeden strukturierten Feed. Die kuratierten Stufen steuern, was sichtbar ist, während Berechtigungen auf der Datenbank und im Dokumenten-Bucket den Zugriff des Agenten bereits an der Quelle einschränken, sodass eine fehlerhafte Anweisung in einem Prompt keine Daten freigeben kann, die der Agent nicht sehen soll. Auf der Seite des Agenten sollte dieser nach dem Least-Privilege-Prinzip nur lesenden Zugriff auf den Wissensbaum erhalten und ausschließlich über eigene Tools arbeiten. Dabei unterscheiden wir zwei Arten von Tools: vertrauenswürdige Tools, die wir selbst entwickelt und getestet haben und die die Unternehmensrichtlinien abbilden, sowie Code, den der Agent selbst erzeugt und der als nicht vertrauenswürdig gilt.
4. Nachvollziehbar (Traceable): Warum gerade dieses Hotel?
Das Angebot für die Familie lautet auf ein Zimmer zur Meerseite im Aurora Bay für 238 € pro Nacht, berechnet auf Basis eines Preises, der vier Stunden alt ist. Als Alex es vorstellt, fragt die Familie, warum der Agent dieses Hotel gewählt hat und nicht eines, das 20 € günstiger ist, und anders als die Antwort aus dem privaten Chat am Anfang lässt sich dieses Angebot erklären. Wie lässt sich eine solche Empfehlung rekonstruieren, wenn ein Audit ansteht oder jemand wissen will, wie der Preis berechnet wurde und woher er stammt?
Für solche Fälle hat sich OpenTelemetry [9] aus unserer Sicht als gut geeignet erwiesen: ein offener Standard zur Aufzeichnung von Traces, Metriken und Logs, den mehr als 90 Observability-Anbieter unterstützen [9] und mit dem ein Agent Prompts, Thinking Traces und Tool-Aufrufe protokolliert. In unseren Projekten bei Posedio kommen zur Analyse dieser Traces sowohl LLM-spezifische Monitoring-Lösungen wie Langfuse [10] als auch klassische Tracing-Tools aus dem Software-Monitoring wie Jaeger [11] zum Einsatz. Für einen Graph-Agenten ist eine solche Aufzeichnung unverzichtbar, weil sie zeigen muss, welchen Zweig der Agent genommen hat und warum, und ohne sie ist ein Audit kaum möglich. Der Trace hält dabei die Metadaten fest und verweist auf die Nutzdaten, anstatt jeden Inhalt selbst zu speichern:
agent.run                         session: sess_88a1
  input:   quiet room, Aurora Bay
  output:  238 EUR/night
  verdict: grounded

LLM_instructions                  780ms
  prompt: hotel_match@v7
  tokens: 1840 in / 96 out

thinking_traces                   310ms
  steps:   3
  plan:    check rate, then noise
  content: not recorded

tool_call: retrieve_knowledge     120ms
  hit: neighborhood.md   0.91
  hit: beach-access.md   0.44

tool_call: read_document          215ms
  lifecycle: current
  policy:    allow
Fragt die Familie, warum der Agent das Aurora Bay und nicht das 20 € günstigere Hotel gewählt hat, lässt sich der Durchlauf anhand des Traces Knoten für Knoten nachspielen.
%%{init: {"theme": "base", "themeVariables": {"background": "#ffffff", "clusterBkg": "#f2f2f2", "clusterBorder": "#d0d0d0", "primaryColor": "#ffffff", "primaryBorderColor": "#9a9a9a", "primaryTextColor": "#222222", "secondaryColor": "#f2f2f2", "tertiaryColor": "#f2f2f2", "lineColor": "#666666", "edgeLabelBackground": "#ffffff"}}}%%
flowchart TB
    q("Ruhiges Zimmer, Aurora Bay, Juli")
    q -- "Abfrage: aurora bay noise" --> k("Wissen abrufen")
    q -- "Abfrage: AURORA-BAY-01" --> r("Preis abfragen")
    k -- "Relevanz 0,91" --> n("neighborhood.md")
    k -. "Relevanz 0,44" .-> b("beach-access.md")
    r -- "4 h alt, innerhalb des SLA" --> p("238 € pro Nacht")
    r -. "nicht für den Agenten lesbar" .-> c("contract-2025.pdf")
    n -- "Befund: ruhige Zimmer zur Meerseite" --> a("Angebot: Aurora Bay, 238 € pro Nacht")
    p --> a
    classDef skipped stroke-dasharray: 5 5,color:#777777
class b,c skippedDas Diagramm konnte nicht dargestellt werden – hier ist der Quelltext.
Die Empfehlung stützt sich auf die Notiz zur Lärmsituation und nicht auf den Preis: Das Aurora Bay wurde wegen seiner ruhigen Zimmer zur Meerseite gewählt, und zwar zu einem Preis, der deutlich innerhalb des 24-Stunden-SLA lag.
5. Produktiv einsetzbar (Operational): Von der Suche zu einem Angebot, das Alex freigeben kann
Im privaten Chat hätte Alex jedes Ergebnis von Hand in die Tools des Reisebüros übertragen müssen. Ein Agent, der mit dem Buchungssystem, den Regeln der Anbieter sowie dem Angebots- und Rechnungsprozess verbunden ist, erstellt das Paket dagegen selbst, während Alex es prüft und freigibt, bevor irgendetwas gebucht wird. Die Bepreisung der Optionen für die Familie fällt dabei in die zweite Kategorie von Tools, also in Code, den der Agent selbst erzeugt, denn der Agent schreibt das SQL, das Flüge und Hotels kombiniert. Auch wenn diese Abfrage über ein vertrauenswürdiges Tool läuft, hat sie ein LLM geschrieben, weshalb sie in einer Sandbox ausgeführt wird. Als Sandbox kommen etwa die Code-Ausführung der Vertex AI Agent Engine [12] oder ein Container auf einem selbst betriebenen Kubernetes-Cluster infrage.
%%{init: {"theme": "base", "themeVariables": {"background": "#ffffff", "clusterBkg": "#f2f2f2", "clusterBorder": "#d0d0d0", "primaryColor": "#ffffff", "primaryBorderColor": "#9a9a9a", "primaryTextColor": "#222222", "secondaryColor": "#f2f2f2", "tertiaryColor": "#f2f2f2", "lineColor": "#666666", "edgeLabelBackground": "#ffffff"}}}%%
flowchart LR
    s1("Agent berechnet die Preise<br/>generierter Code wie SQL-Abfragen") --> s2("Sandbox führt ihn aus<br/>Code-Ausführung der Vertex AI Agent Engine oder ein Container")
    s2 --> s3("Ergebnis prüfen<br/>Plan, Angebot, Preise")
    s3 --> s4("Falsch? Verwerfen<br/>und erneut ausführen")
s4 -.-> s1Das Diagramm konnte nicht dargestellt werden – hier ist der Quelltext.
Die Sandbox isoliert die Ausführung, nicht aber den Zugriff. Berechtigungen müssen deshalb weiterhin auf Datenbankebene durchgesetzt werden, ein Agent darf nur Tools aufrufen, die die Unternehmensrichtlinien zulassen, und jeder Aufruf wird im Trace festgehalten.
Was am Ende dabei herauskommt
%%{init: {"theme": "base", "themeVariables": {"background": "#ffffff", "clusterBkg": "#f2f2f2", "clusterBorder": "#d0d0d0", "primaryColor": "#ffffff", "primaryBorderColor": "#9a9a9a", "primaryTextColor": "#222222", "secondaryColor": "#f2f2f2", "tertiaryColor": "#f2f2f2", "lineColor": "#666666", "edgeLabelBackground": "#ffffff"}}}%%
flowchart LR
    subgraph agents["Agenten"]
        co("Koordinator")
        subgraph search["Suche: parallel"]
            fl("Flüge")
            ho("Hotels")
        end
        subgraph match["Abgleich: Graph"]
            ru{"Regeln"} --> ra("Ranking")
        end
        subgraph price["Preis: Schleife"]
            pr("Preis") --> fi{"Passt?"}
            fi -- "nein" --> pr
        end
        subgraph pkg["Paket: sequenziell"]
            it("Reiseplan") --> qu("Angebot") --> inv("Rechnung")
        end
        co --> fl
        co --> ho
        fl --> ru
        ho --> ru
        ra --> pr
        fi -- "ja" --> it
    end
    subgraph data["Daten"]
        st("Strukturiert") --> dc{"Data Contract"} --> gt[("Gold-Tabellen")]
        un("Unstrukturiert") --> cu{"Kuratierung"} --> okf[("OKF-Wissensbasis")]
    end
    sb("Sandbox")
    fl --> sb
    ho --> sb
    pr --> sb
    sb -- "nur lesend" --> gt
    ra -- "nur lesend" --> okf
    agents -.-> tr[("Traces")]
inv --> con("Beratung") -- "freigeben" --> bk[("Buchung")]Das Diagramm konnte nicht dargestellt werden – hier ist der Quelltext.
Generierter Code läuft in einer Sandbox mit lesendem Zugriff auf die Gold-Tabellen, der Agent liest die OKF-Wissensbasis ebenfalls nur lesend, und jeder Schritt wird in den Traces festgehalten. Am Ende der Kette steht die Freigabe des Angebots durch die Beratung, bevor irgendetwas gebucht wird.
Der Agent, den das Reisebüro schon vor Alex' Start hätte bauen sollen
So bearbeitet Alex die Anfrage der Familie gemeinsam mit dem Agenten, von der ersten Suche bis zur Freigabe des Angebots. Die Zahlen dienen nur der Veranschaulichung; angenommen, die Familie reist in der ersten Juliwoche und bleibt sieben Nächte. Die Anfrage enthält Vorgaben der Familie, des Reisebüros und der Data Contracts:
| Vorgabe | Festgelegt von | Wie der Agent sie prüft |
|---|---|---|
| Vier Reisende, erste Juliwoche, sieben Nächte | Familie | Suchparameter für Flüge und Hotelzimmer |
| Keine Nachtflüge | Familie | Filter auf Abflug- und Ankunftszeiten in der Flugsuche |
| Ruhiges Hotel | Familie | Notizen zur Lärmsituation in neighborhood.md |
| Nähe zum Strand | Familie | Entfernung und Weg in beach-access.md |
| Freundliches Personal | Familie | Notizen zum Personal in staff-service.md |
| Gesamtpreis unter 3.000 € | Familie | Preisschleife in der Sandbox |
| Regeln der Anbieter und Stornobedingungen | Reisebüro | Entscheidungstabellen im Graph |
| Preis nicht älter als 24 Stunden | Data Contract | Freshness-SLA des Preis-Feeds |
| Nur aktuelle Dokumente, die der Agent lesen darf | Richtlinie des Reisebüros | lifecycle und visibility im Frontmatter |
Mit diesen Vorgaben arbeitet der Agent die Anfrage in folgenden Schritten ab:
- Der Koordinator startet Flug- und Hotelsuche parallel. Die Flugsuche verwirft dabei eine Verbindung mit Abflug um 23:40 Uhr, weil die Familie Nachtflüge ausgeschlossen hat.
- Der Graph wendet die Regeln der Anbieter und die Stornobedingungen auf die gefundenen Hotels an und entfernt jedes Angebot, dessen Bedingungen das Reisebüro nicht akzeptiert.
- Der Agent reiht die verbleibenden Hotels anhand der Notizen aus der Wissensbasis. Angenommen, das Marina Plaza kostet 218 € pro Nacht und damit 20 € weniger als das Aurora Bay, doch seine
neighborhood.mdbeschreibt nächtlichen Straßenlärm, während die Notiz zum Aurora Bay von ruhigen Zimmern zur Meerseite spricht. Das Aurora Bay landet deshalb auf Platz eins. - Der Agent erzeugt das SQL, das Flüge und Hotel kombiniert, und die Sandbox führt es lesend auf den Gold-Tabellen aus. Angenommen, die erste Kombination nutzt Tagflüge für 1.480 € und kommt mit sieben Nächten zu je 238 € auf 3.146 €, was über dem Budget liegt. Die Schleife bepreist daraufhin die nächste Tagesverbindung für 1.120 €, womit die Gesamtsumme auf 2.786 € sinkt und die Schleife endet.
- Bevor der Agent antwortet, prüft er erneut, ob für AURORA-BAY-01 ein indexierter Vertrag existiert, ob der Preis mit seinen vier Stunden innerhalb des 24-Stunden-SLA liegt, ob die Lärmnotiz den Lifecycle-Zustand
currenthat und ob die Richtlinien dem Agenten erlauben, sie zu lesen. Je nachdem, welche Prüfung fehlschlägt, gibt der Agent keine Antwort, eskaliert den veralteten Preis, bietet die Notiz nur als ungeprüften Entwurf an oder erhält keinen Zugriff auf das Dokument. In diesem Fall bestehen alle Prüfungen; abgelehnt wird lediglich der Versuch,contract-2025.pdfzu öffnen, weil der Vertrag nicht als für den Agenten lesbar gekennzeichnet ist. - Der Paketschritt erstellt Reiseplan, Angebot und Rechnung als einfache Funktionsaufrufe.
- Jeder Schritt wird im Trace festgehalten, und Alex prüft das Angebot als zuständige Beraterin und gibt es frei, bevor irgendetwas gebucht wird.
6. Erweiterbar (Expandable): Die nächste Anfrage kommt mit dem Rucksack
Angenommen, als Nächstes sitzt eine Person an Alex' Tisch, die mit dem Rucksack unterwegs ist und mit einem Budget von 800 € Hostels und Regionalzüge sucht. Alex öffnet keinen neuen Chat und fügt keine neuen Dokumente ein, denn der Agent kann die Anfrage ohne Umbau übernehmen, da jeder Teil davon bereits einen festen Platz hat. Die Preise der Hostels kommen als neuer Feed mit eigenem Data Contract herein und durchlaufen dieselben Stufen Bronze, Silber und Gold. Bewertungen von Hostels werden zu neuen OKF-Dokumenten mit demselben Frontmatter, die auf dieselbe Weise gepflegt und geprüft werden. Zugverbindungen kommen als neues vertrauenswürdiges Tool hinzu, das die Richtlinien des Reisebüros abbildet und in die Liste der Tools aufgenommen wird, die der Agent aufrufen darf, sodass Sandbox, Berechtigungen und Traces dafür genauso gelten wie für alle anderen. Der Prozess behält seine Bausteine: eine parallele Suche, einen Graph mit den Regeln der Anbieter, eine Preisschleife gegen das Budget und einen sequenziellen Paketschritt.
Die sechs Säulen auf einen Blick
%%{init: {"theme": "base", "themeVariables": {"background": "#ffffff", "clusterBkg": "#f2f2f2", "clusterBorder": "#d0d0d0", "primaryColor": "#ffffff", "primaryBorderColor": "#9a9a9a", "primaryTextColor": "#222222", "secondaryColor": "#f2f2f2", "tertiaryColor": "#f2f2f2", "lineColor": "#666666", "edgeLabelBackground": "#ffffff"}}}%%
flowchart TB
    subgraph row1[" "]
        direction LR
        P1("Vertrauenswürdig (Trusted)<br/>Die Daten, die der Agent liest, sind korrekt und aktuell")
        P2("Kontextbezogen (Contextual)<br/>Der Agent weiß, was die Daten bedeuten")
        P3("Kontrolliert (Governed)<br/>Berechtigungen und Richtlinien begrenzen, was er tun darf")
        P1 ~~~ P2 ~~~ P3
    end
    subgraph row2[" "]
        direction LR
        P4("Nachvollziehbar (Traceable)<br/>Jede Entscheidung und jeder Tool-Aufruf wird aufgezeichnet und lässt sich zurückverfolgen")
        P5("Produktiv einsetzbar (Operational)<br/>Der Agent kann in Produktivumgebungen handeln")
        P6("Erweiterbar (Expandable)<br/>Seine Fähigkeiten lassen sich ohne Umbau erweitern")
        P4 ~~~ P5 ~~~ P6
    end
row1 ~~~ row2Das Diagramm konnte nicht dargestellt werden – hier ist der Quelltext.
Jede Säule greift einen Teil dessen auf, was bei Alex schiefgelaufen ist. Ein Agent, der seine Antworten nur auf geprüfte und aktuelle Daten stützt (Säule 1, vertrauenswürdig), hätte die Dokumente ersetzt, die Alex in den Chat kopiert hat, ohne zu wissen, ob sie noch aktuell waren. Ein Agent, der weiß, was die Daten des Reisebüros bedeuten (Säule 2, kontextbezogen), hätte einen Wunsch wie „ruhig“ mit Bewertungen und Fragebögen abgeglichen, statt von den Ausschnitten abzuhängen, die Alex zufällig ausgewählt hatte. Ein Agent, dessen Berechtigungen und Richtlinien festlegen, was er lesen und tun darf (Säule 3, kontrolliert), hätte die internen Dokumente im Reisebüro gehalten, ganz ohne privates Konto. Ein Agent, der jede Entscheidung und jeden Tool-Aufruf aufzeichnet (Säule 4, nachvollziehbar), hätte jede Empfehlung auf die zugrunde liegenden Dokumente zurückführbar gemacht, was bei ihrer Chat-Antwort nicht möglich war. Ein Agent, der mit dem Buchungssystem, den Regeln der Anbieter sowie dem Angebots- und Rechnungsprozess verbunden ist (Säule 5, produktiv einsetzbar), hätte ihr das Hin- und Herkopieren zwischen Chatfenster und den Tools des Reisebüros erspart. Und ein Agent, der sich ohne Umbau erweitern lässt (Säule 6, erweiterbar), übernimmt auch die nächste Anfrage, etwa die Rucksackreise, ohne dass Alex einen neuen Chat mit neu eingefügten Dokumenten beginnen muss.
Wie es weitergeht
Aus unserer Sicht bei Posedio muss ein Agent nicht als große Plattform beginnen. Ein einzelner, klar abgegrenzter Geschäftsprozess wie die Erstellung eines Angebots genügt, um herauszufinden, welche Daten der Agent braucht, welche Regeln gelten und wer das Ergebnis freigeben muss. Das Reisebüro in diesem Beitrag ist dabei nur ein Beispiel unter vielen: Eine Schadensmeldung bei einer Versicherung, ein Support-Ticket oder eine Bestellung werfen dieselben Fragen nach Datenqualität, Zugriff, Nachvollziehbarkeit und Freigabe auf, weshalb wir davon ausgehen, dass auch ein Agent für jeden dieser Fälle auf denselben sechs Säulen ruht.
Dieser Beitrag basiert auf einem Vortrag von Martin Mayr und Adrian Dimaano am 24.09.2026 beim GCP Meetup [13].
References
[1] Making Your Data Ready for Agentic AI, Pramod Sadalage and Prem Chandrasekaran, Accessed at 14-10-2026
[2] Microsoft and LinkedIn release the 2024 Work Trend Index on the state of AI at work, Microsoft, Accessed at 14-10-2026
[3] A Practical Guide for Designing, Developing, and Deploying Production-Grade Agentic AI Workflows, Eranga Bandara et al., Accessed at 14-10-2026
[4] 2026 State of Data Integrity and AI Readiness, Precisely and the Center for Applied AI and Business Analytics at Drexel University's LeBow College of Business, Accessed at 14-10-2026
[5] Open Data Contract Standard, Bitol (Linux Foundation AI & Data), Accessed at 14-10-2026
[6] What is the medallion lakehouse architecture?, Databricks, Accessed at 14-10-2026
[7] Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Patrick Lewis et al., Accessed at 14-10-2026
[8] How the Open Knowledge Format can improve data sharing, Sam McVeety and Amir Hormati, Accessed at 14-10-2026
[9] OpenTelemetry Documentation, OpenTelemetry Authors (Cloud Native Computing Foundation), Accessed at 14-10-2026
[10] OpenTelemetry (OTEL) for LLM Observability, Langfuse, Accessed at 14-10-2026
[11] Jaeger Documentation: Introduction, The Jaeger Authors (Cloud Native Computing Foundation), Accessed at 14-10-2026
[12] Vertex AI Agent Engine Code Execution, Google Cloud, Accessed at 14-10-2026
[13] Google Cloud Meetup Vienna, Meetup, Accessed at 22-10-2026